ستة أيام مع الوكلاء، و14 إلى 20 شهرًا للبشر.
تحليل للجهد المبذول في Proven، أداة مفتوحة المصدر لمراجعة الشيفرة بناها وكلاء البرمجة بالذكاء الاصطناعي بموافقة شخص واحد في Open Agent Hackathon في أكتوبر 2026. قسنا ما تم تسليمه، ثم قدّرنا بأربع طرق منشورة ما يحتاجه فريق تقليدي لبناء الشيء نفسه. يمكن التحقق من كل رقم في المستودع العام.
اقرأ التقرير (PDF بالإنجليزية،) ←المستودع عند الوسم المقاس ←
المقارنة
| بناه الوكلاء بموافقة معتمِد واحد | التقدير لفريق بشري | |
|---|---|---|
| الوقت التقويمي | بناه الوكلاء بموافقة معتمِد واحد139 ساعة، من أول commit للبناء حتى التسليم | التقدير لفريق بشري14 إلى 20 شهرًا |
| الأشخاص | بناه الوكلاء بموافقة معتمِد واحدمعتمِد واحد يقرر ويدمج ولا يكتب الشيفرة، ووكلاء الذكاء الاصطناعي | التقدير لفريق بشري9 إلى 11 شخصًا بدوام كامل في 8 أدوار |
| الجهد | بناه الوكلاء بموافقة معتمِد واحدغير قابل للمقارنة بأشهر العمل | التقدير لفريق بشري100 إلى 225 شهر عمل، والتقدير الأوسط 135 إلى 180 |
| شيفرة الإنتاج | بناه الوكلاء بموافقة معتمِد واحد42,036 سطرًا من Go، و9,246 سطرًا من shell وTypeScript وPython وSQL | التقدير لفريق بشريالنطاق نفسه |
| الاختبارات | بناه الوكلاء بموافقة معتمِد واحد58,956 سطرًا من Go، و1,828 دالة اختبار | التقدير لفريق بشريالنطاق نفسه |
| السجل | بناه الوكلاء بموافقة معتمِد واحد53 سجلًا لقرارات معمارية؛ 307 أحكام مراجعة في 154 مراجعة مستقلة، منها 113 رفضًا | التقدير لفريق بشريعادةً جزئي: تعليقات طلبات الدمج والتذاكر |
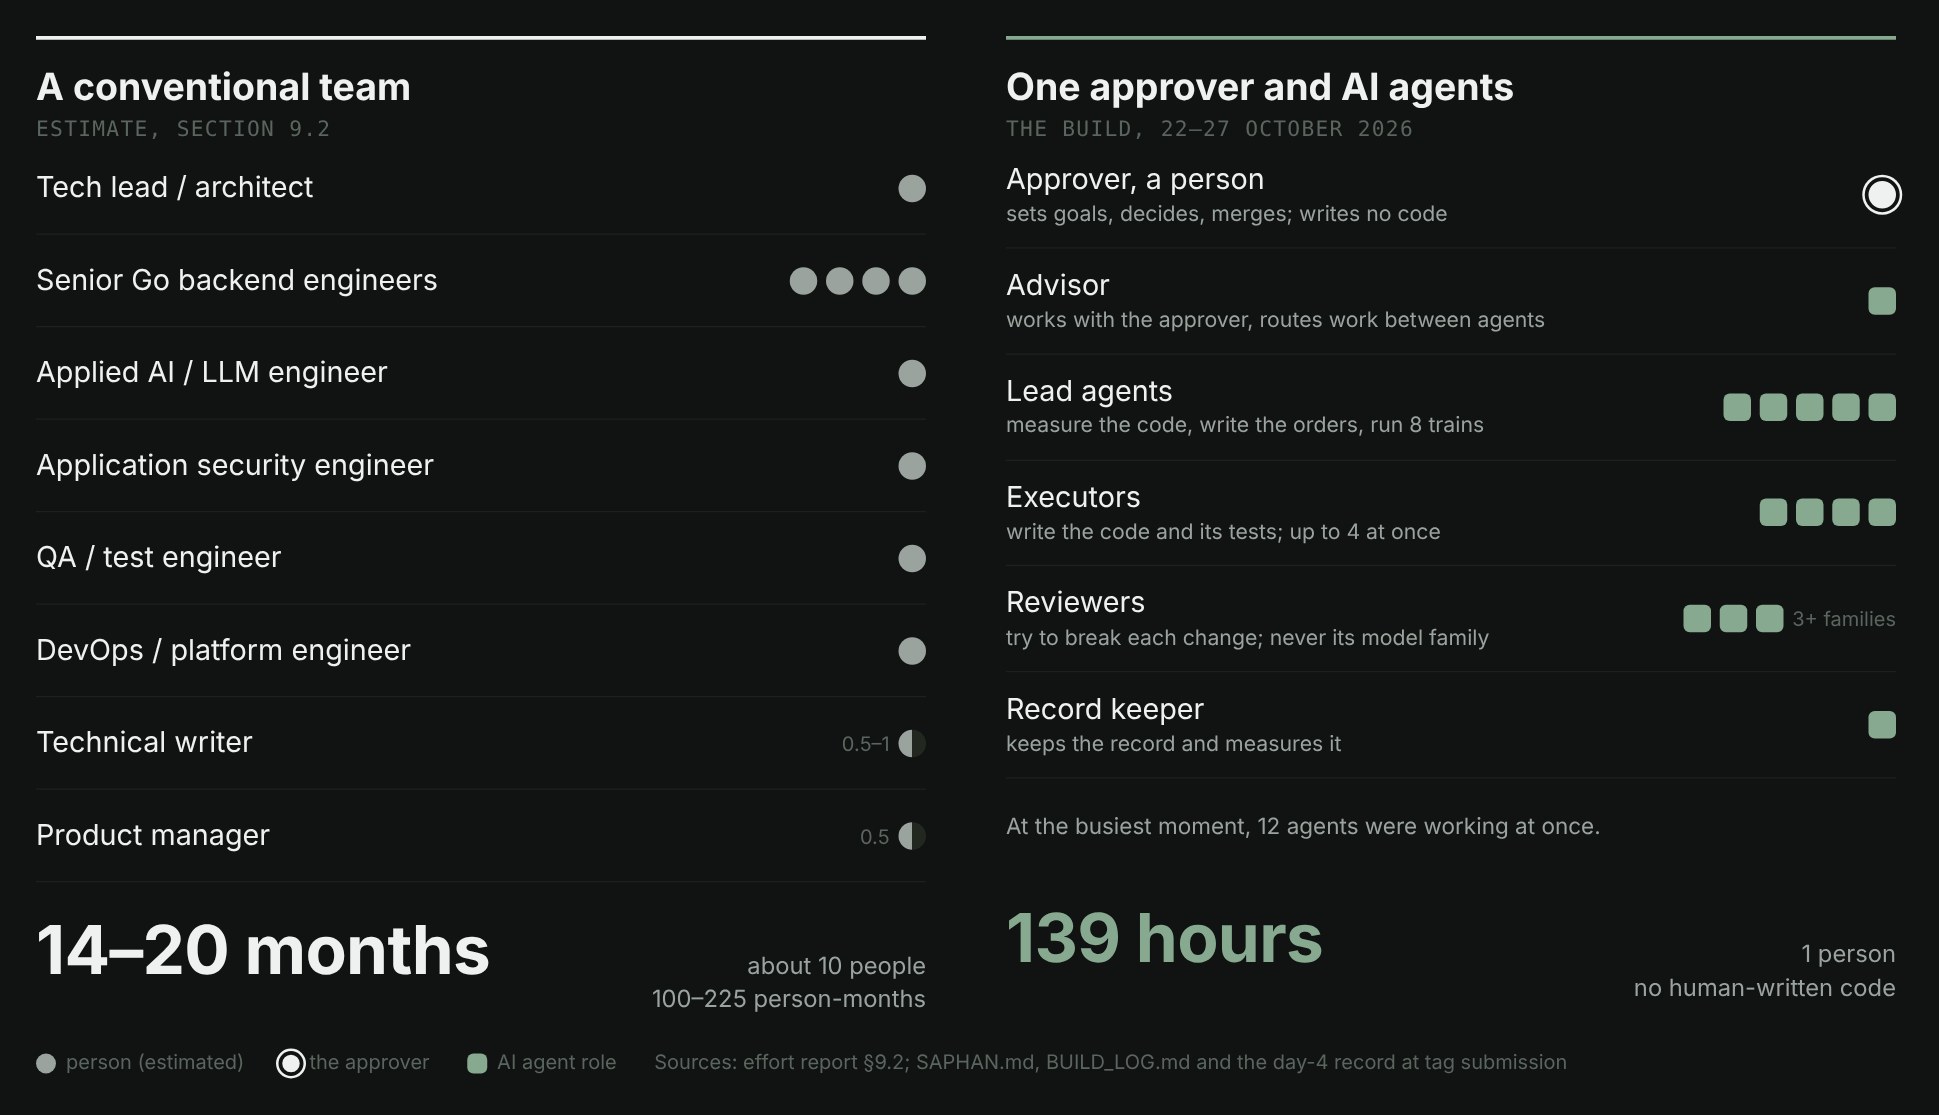
يأتي التقدير من COCOMO II، وقاعدة بيانات QSM للمشاريع المكتملة، ونطاقات الإنتاجية لستيف ماكونيل، وعدٍّ تصاعدي حسب حزم العمل. المقارنة تخص الوقت التقويمي والنطاق، لا ما إذا كان الوكلاء مبرمجين أفضل.
جودة الشيفرة مقارنةً بمعايير منشورة
تغطية الاختبارات: 80.9%
أعلى من 75%، وهي المستوى الرابع في مستويات التغطية الطوعية لدى Google (Ivanković وآخرون، 2019). قيست على الحزم التي تضم 64% من شيفرة الإنتاج، ويشرح التقرير السبب.
واجهة برمجية عامة موثّقة: 96.1%
لدى 1,490 من أصل 1,550 معرّفًا مُصدَّرًا في Go تعليقُ توثيق. إرشادات Go تطلبه لكل معرّف.
كثافة التعليقات: 18.7%
المتوسط عبر أكثر من 5,000 مشروع مفتوح المصدر هو 18.67% (Arafat وRiehle، 2009).
التعقيد: 88.9% من الدوال عند 10 أو أقل
حد ماكابي لكل دالة (NIST SP 500-235). توجد قيمة شاذة واحدة معروفة، مذكورة في README تحت Honest limits.
ما لا تدّعيه هذه المقارنة
أسطر الشيفرة تقيس الحجم لا القيمة.
نماذج التقدير معايَرة على مشاريع بشرية، واستخدامها هنا يفترض أن النطاق نفسه يعني الحجم نفسه.
تساوي الجودة غير مُثبت.
يسرد README القيود المفتوحة. ربما كان فريق بشري سيسلّم ميزات أقل بقيود معروفة أقل.
ستة أيام ليست الجهد كله.
جاء الموضوع و25 قرارًا تصميميًا من التخطيط بين 16 و21 أكتوبر، ويعمل الوكلاء على Saphan Studio الذي بُني قبل الهاكاثون.
ليس كل شيء مقاسًا.
ساعات عمل المعتمِد ليست في السجل، ولا تنشر هذه النسخة العامة أرقامًا مالية لبناء الوكلاء.
تحقّق بنفسك
يعطي القسم 11 من التقرير الأوامر لكل رقم: انسخ المستودع، وانتقل إلى الوسم submission، ثم احسب. ابدأ بقسم Honest limits في README، ثم hackathon/fleet/LEDGER.md: كل تغيير، والنموذج الذي بناه، وجولاته وشروطه.
المزيد عن Saphan Studio
البحث — دراسة وكلاء الذكاء الاصطناعي أثناء العمل ←الحوكمة — قرارات في السجل ←البروتوكول — كيف يعمل الوكلاء ←
أسئلة عن المنهجية، أو تريد القياس نفسه على عمل فريقك؟
تواصل معنا — hello@saphan.ai